
Replication Lag Alarmından Müdahaleye: Eskalasyon Runbook’u
Replica gecikmesi alarmı çaldığında panikle parametre değiştirmek yerine kontrollü müdahale: teyit, etki analizi, teşhis, eskalasyon, eylem ve toparlanma.
▸Kısa Açıklama
Replication lag için tek bir evrensel eşik yoktur. Alarmı replica’nın kullanımına, iş etkisine ve ölçüm güvenilirliğine bağlayın.
Raporlama replica’sındaki gecikme ile kritik okuma yolundaki gecikme aynı öncelikte olmayabilir. Failover adayının durumu da ayrıca değerlendirilmelidir. Olay yönetimine metrikten önce hizmet bağlamını ekleyin.
Replication lag olaylarında teknik teşhis kadar koordinasyon da önemlidir. Bir ekip ağ sorununu araştırırken başka bir ekip replica’yı yeniden başlatırsa, hem kanıt kaybolabilir hem de müdahalenin etkisi anlaşılamayabilir.
Bu runbook’un amacı her alarmı aynı prosedüre zorlamak değil; ölçümü doğrulayan, iş etkisini belirleyen ve riskli işlemleri kontrollü tutan ortak bir müdahale düzeni oluşturmaktır.
▸Önceden Doldurulacak Hizmet Kartı
| Alan | Ekip tarafından belirlenecek bilgi |
|---|---|
| Hizmet ve topoloji | Primary, replica’lar, roller ve varsa cascading bağlantılar |
| Kullanım amacı | Raporlama / Okuma trafiği / HA adayı |
| İş hedefi | Kabul edilen veri eskiliği ve kurtarma hedefleri |
| Normal davranış | Yoğun saatler, kasıtlı gecikme, bakım penceresi |
| Sorumlular | Nöbetçi, yedek, DBA, platform ve uygulama sorumlusu |
| Referanslar | Dashboard, teknik runbook, değişiklik ve failover prosedürü |
Replay gecikmesi tek başına veri kaybı veya RPO ölçümü değildir. Failover değerlendirmesi dayanıklılık, WAL konumları, senkronizasyon politikası ve topolojiyi birlikte ele almalıdır.
Hizmet kartını tamamlamak için ayrıca şu kararları kaydedin:
- Hangi okumalar eski veriye toleranslıdır?
- Hangi okumalar daha güncel bir veri kaynağına yönlendirilmelidir?
- Replica devre dışı bırakılırsa primary veya diğer replica’lar ek yükü taşıyabilir mi?
- Müdahale sırasında değişiklik onayını kim verir?
- Hizmetin normale döndüğünü kim doğrular?
▸İş Etkisine Göre Önceliklendirin
| Gözlenen durum | Değerlendirilecek etki | Önceliklendirme yaklaşımı |
|---|---|---|
| Raporlama replica’sında geçici birikim | Rapor güncelliği hedefi ve iş takvimi | Süreklilik ve hedef ihlaline göre değerlendirin |
| Okuma replica’sında güncellik ihlali | Kullanıcıların eski veya eksik bilgi görmesi | Uygulama sorumlusunu erken dahil edin |
| HA adayının bağlantı kaybı | Yedeklilik ve kurtarma hazırlığının zayıflaması | Diğer adayların durumunu birlikte inceleyin |
| Senkron replikasyonla ilişkili commit beklemesi | Primary üzerindeki yazma hizmetinin etkilenmesi | Hizmet etkisini ve senkronizasyon politikasını doğrulayın |
| WAL saklama ve primary disk riski | Sorunun primary hizmetine yayılması | Rutin inceleme sırasını beklemeden eskale edin |
Senkron replikasyonda etki, kullanılan commit politikası ve hangi standby’ların onayının beklendiğiyle ilişkilidir. Her replica’daki replay gecikmesini otomatik olarak primary commit gecikmesiyle eşitlemeyin.
▸Alarm Tasarım Şablonu
| Alarm sınıfı | Koşulun tasarımı | İlk yönlendirme |
|---|---|---|
| Ölçüm alınamıyor | Veri tazeliği sınırı aşıldı veya collector erişimi kayboldu | Monitoring/platform sorumlusu |
| Beklenen replica yok | Envanterde mevcut, bağlantı gözlemlerinde yok | Nöbetçi DBA; ağ/platform desteği |
| Sürekli birikim | Byte açığı belirlenen süre boyunca büyüyor | DBA; kanıta göre platform |
| Veri güncelliği ihlali | Hizmete özel kabul sınırı güvenilir ölçümle aşıldı | DBA ve uygulama sorumlusu |
| WAL/disk riski | Retention ve tüketim eğilimi disk güvenliğini tehdit ediyor | Acil DBA ve platform müdahalesi |
Ölçüm alınamıyorsa durum “bilinmiyor”dur. Bu durum, replikasyonun sağlıklı olduğunu da bozuk olduğunu da tek başına kanıtlamaz; ancak görünürlük kaybı ayrı bir operasyonel risktir.
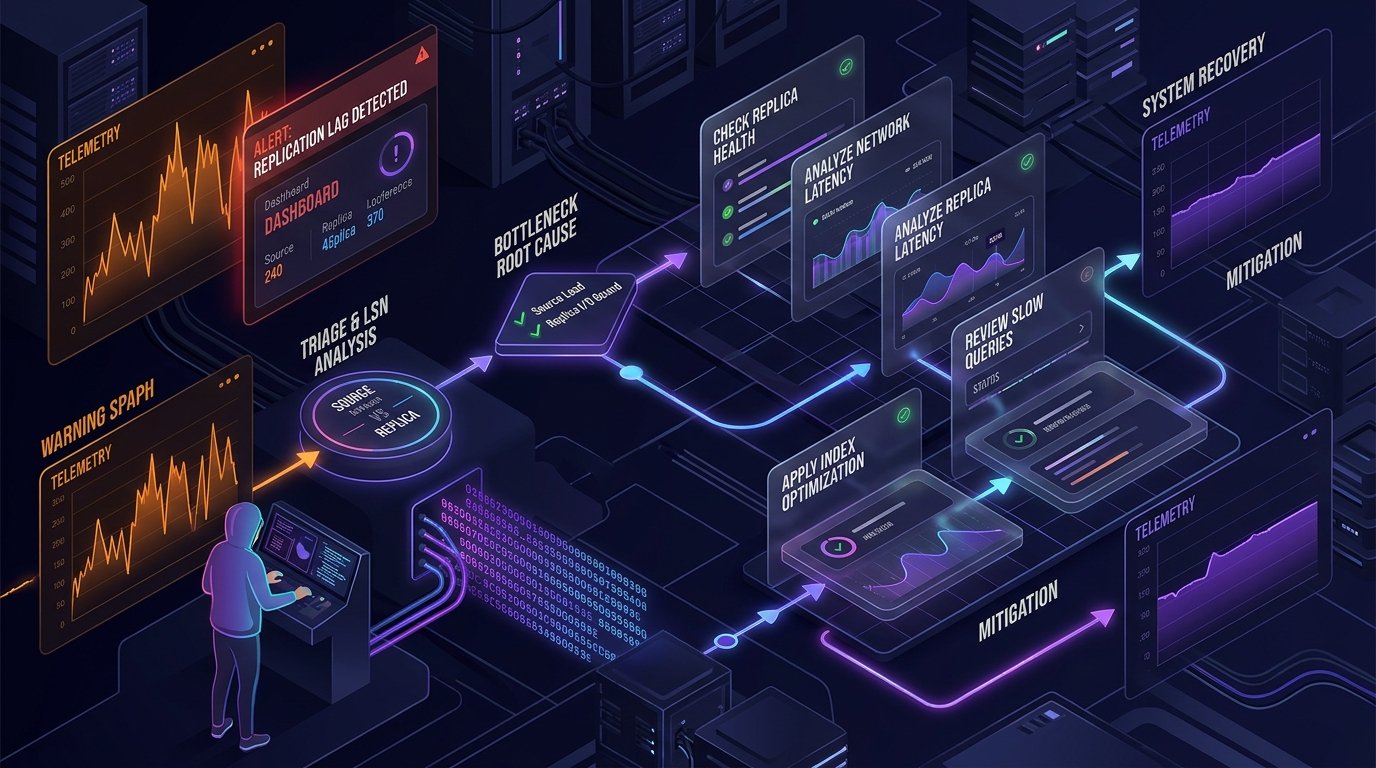
▸Alarm Geldiğinde (İlk 7 Adım)
- 1Sahiplenin: Olay kaydı açın; hizmeti, replica’yı ve ilk gözlem zamanını belirtin.
- 2Ölçümü doğrulayın: Son örnek zamanı, collector sağlığı, node rolü ve bakım durumunu kontrol edin.
- 3Etkiyi belirleyin: Kullanıcı eski veri görüyor mu? Primary commit gecikmesi var mı? Replica başka HA adaylarıyla birlikte nasıl konumlanıyor?
- 4Darboğazı ayırın: dbaguide runbook’u üzerinden gönderim, aktarım ve replay hattını inceleyin.
- 5Kanıta göre eskale edin: Ağ bulgusu platform/ağ ekibine; depolama bulgusu platforma; iş yükü değişikliği uygulama sorumlusuna gider. DBA teknik koordinasyonu sürdürür.
- 6Kontrollü aksiyon alın: Okuma trafiği yönlendirme gibi seçeneklerde primary kapasitesi ve uygulama tutarlılık ihtiyacını değerlendirin. Failover veya slot silmeyi lag alarmının otomatik aksiyonu yapmayın.
- 7Toparlanmayı doğrulayın: Bağlantı, birikim eğilimi, ölçüm tazeliği ve uygulama güncelliğini birlikte kontrol edin.
▸Müdahale Seçenekleri ve Karar Kapıları
| Olası aksiyon | Önce doğrulanacak konu | Başlıca risk |
|---|---|---|
| Etkilenen replica’dan okuma trafiğini azaltmak | Alternatif hedeflerin kapasitesi ve yönlendirme davranışı | Yükün başka node’a taşınması |
| Ağır raporlama işini ertelemek | İşin önemi, yeniden çalıştırılabilirliği ve sorunla ilişkisi | İş takviminin etkilenmesi |
| Toplu yazma işini yavaşlatmak | Uygulama sahibinin onayı ve iş etkisi | Veri işleme sürelerinin uzaması |
| Planlı replay duraklatmasını sonlandırmak | Duraklatma amacı ve yetkili onayı | Korunması gereken recovery durumunun bozulması |
| Kaynak kapasitesini değiştirmek | Gerçek darboğaz, platform sınırları ve işlem etkisi | Yanlış kaynağı artırmak veya ek kesinti |
| Replica’yı yeniden oluşturmak | Gerekli WAL’ın erişilebilirliği ve yeniden kurulum planı | Uzun süreli kapasite/HA kaybı |
| Failover | Ayrı failover prosedürü, aday durumu ve eski primary’nin güvenli biçimde devreden çıkarılması | Veri kaybı, tutarsızlık veya çift primary riski |
Replication slot silmek veya WAL dosyalarını elle kaldırmak, disk baskısına karşı rutin temizlik işlemi olarak ele alınmamalıdır. Slotlar replica’nın ihtiyaç duyduğu WAL’ın korunmasında rol oynar; aynı zamanda WAL saklama nedeniyle primary disk riskine katkıda bulunabilir. Bu iki yön birlikte değerlendirilmelidir.
▸Olay Mesajı Şablonu
[Hizmet] / [Replica] için [zaman] itibarıyla replication bozulması inceleniyor.
Ölçüm tazeliği: [...]
Doğrulanan etki: [...]
Şüpheli aşama: [...]; kök neden henüz [doğrulandı/doğrulanmadı].
Mevcut aksiyon: [...]
Sorumlu: [...]
Bir sonraki güncelleme: [...]▸Olay Ne Zaman Kapatılır?
Sadece alarm sustuğunda değil; metrikler tazeyken, beklenen replica’lar görülürken, hizmet güncellik hedefi karşılanırken ve birikim tanımlı toparlanma penceresi boyunca kabul edilebilir seviyede kalırken kapatın.
Kapanış öncesinde şunları kontrol edin:
- Geçici trafik yönlendirmeleri geri alındı mı veya kalıcı hale mi getirildi?
- Askıya alınan işler kontrollü şekilde yeniden başlatıldı mı?
- Açılan susturmalar kapatıldı mı?
- Slot/WAL saklama ve disk riski normale döndü mü?
- Kullanıcı etkisinin kalktığını ilgili hizmet sahibi doğruladı mı?
▸Olay Sonrası İncelemeyi Uygulanabilir Aksiyona Dönüştürün
| İnceleme bulgusu | Somut takip aksiyonu örneği | Kabul kanıtı |
|---|---|---|
| Replica kaybı fark edilmedi | Envanter tabanlı eksik replica kontrolü eklemek | İzole kesinti testinde beklenen alarm |
| Eski ölçüm sağlıklı gösterildi | Veri tazeliğini dashboard ve alarm koşuluna eklemek | İzleme kesintisi testinde bilinmeyen durum |
| Bildirim sahipsiz kaldı | Yedek nöbetçi ve sahiplenme eskalasyonu tanımlamak | Uçtan uca bildirim tatbikatı |
| Teknik teşhis uzadı | WAL aşamaları ve kaynak metriklerini ilişkilendirmek | Runbook tatbikatında kanıta ulaşılması |
| Toparlanma erken ilan edildi | Hizmet güncelliğini kapanış kriterine eklemek | Kapanış kaydında uygulama doğrulaması |
▸Kaynaklar
▸Replikasyon Sağlığı Ortak Seri Bağlantıları
- Teknik teşhis ve salt okunur SQL adımları için dbaguide: PostgreSQL Replication Lag: Darboğazı Adım Adım Teşhis Etme
- İzleme çözümleri ve pilot test kontrol listesi için dataxtools: Replication Lag İzleme: Araçlarda Hangi Özellikleri Aramalısınız?
Replikasyon Olay Yönetimi & Eskalasyon Deneyiminizi Paylaşın
Üretim ortamınızdaki replikasyon alarmlarını, eskalasyon süreçlerinizi ve müdahale deneyimlerinizi paylaşarak sektör benchmark'larına katkıda bulunun.
PostgreSQL Replication Lag: Darboğazı Adım Adım Teşhis Etme
Primary ve standby üzerinde salt okunur SQL kontrolleriyle WAL üretim, gönderim, aktarım ve replay darboğazlarını izole edin.
Replication Lag İzleme: Araçlarda Hangi Özellikleri Aramalısınız?
postgres_exporter vs Percona PMM: Ölçüm güvenilirliği, boşta sistem davranışı, minimum dashboard tasarımı ve pilot test planı.
Bu mimariyi üretimde test etmek ister misiniz?
DataOpsphere CI/CD şablonlarını ve Docker Compose ortamlarını kopyalayıp hemen çalıştırabilirsiniz.